04 / Blog · 10.09.2026
Staging ist eine Wiederherstellungsprobe, keine Kopie der Produktion
Eine belastbare Staging-Umgebung entsteht nicht durch einen weiteren Server. Sie beweist, dass sich Code, Konfiguration, Daten und Dateien kontrolliert wiederherstellen lassen – ohne Produktionszugänge, echte Benachrichtigungen oder unbemerkte personenbezogene Kopien mitzunehmen.
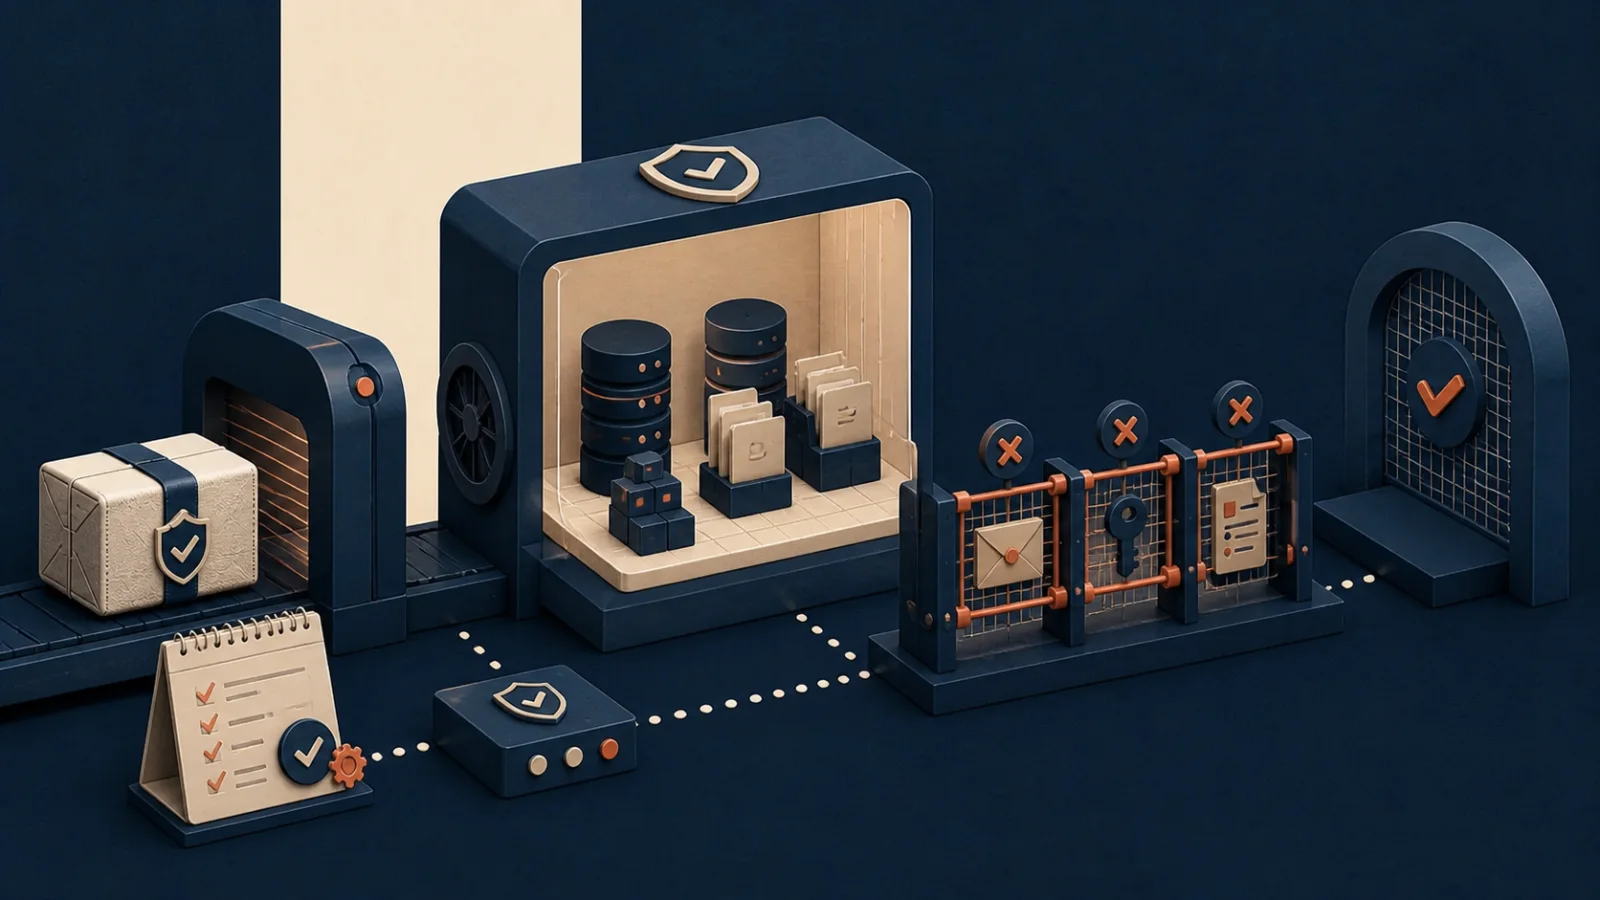
Ein grünes Staging kann die falsche Sicherheit liefern
Die Staging-Website ist erreichbar, das Backend öffnet sich und einige Seiten sehen plausibel aus. Damit scheint die Vorproduktionsumgebung ihren Zweck zu erfüllen. Doch diese Beobachtung beweist erstaunlich wenig.
Vielleicht wurde die Datenbank vor Monaten manuell importiert. Vielleicht fehlen private Dateien, während ihre FAL-Referenzen noch bestehen. Vielleicht nutzt die Umgebung andere PHP-Erweiterungen als die Produktion. Möglicherweise funktionieren E-Mails nur deshalb, weil niemand bemerkt hat, dass sie weiterhin an echte Empfänger gehen.
Eine belastbare Staging-Umgebung sollte deshalb nicht als langlebige Kopie der Produktion verstanden werden. Ihr eigentlicher Wert liegt in einem wiederholbaren Vorgang:
Artefakte auswählen
→ isolierte Umgebung aufbauen
→ Daten wiederherstellen
→ Daten und Konfiguration transformieren
→ Anwendung starten
→ fachliche Eigenschaften prüfen
→ Umgebung kontrolliert freigeben
Damit wird Staging zu einer Wiederherstellungsprobe. Es beantwortet nicht nur die Frage, ob ein neuer Build läuft, sondern auch, ob Backups verwendbar, Umgebungsgrenzen wirksam und betriebliche Annahmen automatisierbar sind.
Ein Backup ist zunächst nur ein Versprechen
Eine erfolgreiche Backup-Meldung bedeutet, dass ein Prozess Dateien geschrieben hat. Sie sagt noch nicht, ob alle benötigten Bestandteile enthalten, miteinander konsistent, entschlüsselbar und mit der aktuellen Anwendung verwendbar sind.
Für eine TYPO3-Anwendung können mindestens diese Artefakte relevant sein:
| Bestandteil | Beispiele | Typisches Risiko | |---|---|---| | Anwendung | Composer-Lockdatei, Extensions, Frontend-Build | nicht mehr reproduzierbare Abhängigkeiten | | Konfiguration | Site-Konfiguration, TypoScript, Dienste | Umgebungseinstellungen fehlen oder werden verwechselt | | Datenbank | Inhalte, Benutzer, Extension-Tabellen | Dump ist unvollständig oder inkompatibel | | Dateispeicher | öffentliche und private Uploads | Datenbankreferenz zeigt auf fehlende Datei | | Schlüssel | Backup-, Medien- oder Anwendungsschlüssel | Daten sind vorhanden, aber nicht entschlüsselbar | | externe Zustände | Suchindex, Objekt-Storage, Queues | Ableitungen passen nicht zum wiederhergestellten Stand | | Betriebswissen | Reihenfolge, Zugang, Freigaben | Restore hängt von Erinnerung Einzelner ab |
Die TYPO3-Sicherheitsdokumentation empfiehlt ausdrücklich, Backups regelmäßig auf Vollständigkeit und Wiederherstellbarkeit zu testen. Sie warnt außerdem vor Sicherungen im Webroot und weist darauf hin, dass mehrere zeitlich getrennte Versionen nötig sein können: Ein aktuelles Backup kann bereits manipulierte Konfiguration oder beschädigte Daten enthalten. (TYPO3: Backups and recovery)
Der Restore-Test sollte deshalb nicht immer nur „das neueste Backup“ verwenden. Ein realistischer Prüfplan umfasst auch ältere Wiederherstellungspunkte und dokumentiert, welche Anwendungsversion dazu gehört.
Wiederherstellung braucht ein Manifest
Wenn Datenbank, Dateien und Code getrennt gesichert werden, benötigt der Wiederherstellungsprozess einen gemeinsamen Bezugspunkt. Dafür genügt ein kleines Manifest:
{
  "backupId": "2026-08-19T020000Z",
  "applicationRevision": "8c31f2a",
  "database": {
    "artifact": "database.sql.zst",
    "sha256": "..."
  },
  "files": {
    "artifact": "uploads.tar.zst",
    "sha256": "..."
  },
  "schemaVersion": 17,
  "createdAt": "2026-08-19T02:00:00Z"
}
Das Manifest sollte keine Zugangsdaten enthalten. Es verbindet lediglich Artefakte, Versionen und Prüfsummen. Der Restore kann dadurch früh abbrechen, wenn ein Teil fehlt oder beschädigt ist.
Zeitliche Nähe allein stellt noch keine Konsistenz her. Ein Datenbank-Dump von 02:00 Uhr und ein Dateisnapshot von 02:30 Uhr können fachlich auseinanderliegen. Je nach Anwendung braucht es daher eine definierte Snapshot-Strategie, einen kurzen Schreibstopp oder eine nachgelagerte Konsistenzprüfung.
Wichtig ist die ehrliche Bezeichnung des Ergebnisses:
archived  → Artefakt wurde gespeichert
verified  → Prüfsumme und Lesbarkeit wurden geprüft
restored  → Artefakte wurden in eine Umgebung eingespielt
accepted  → Anwendung und definierte Fachpfade wurden erfolgreich geprüft
Erst die letzte Stufe belegt, dass aus den gespeicherten Bestandteilen wieder ein nutzbares System entstehen kann.
Produktionsnähe betrifft Struktur, nicht Freizügigkeit
Staging soll relevante Eigenschaften der Produktion abbilden: Laufzeitversionen, Datenbanksystem, Cache, Routing, Dateispeicher, Queue-Verhalten und Sicherheitsmiddleware. Daraus folgt nicht, dass dieselben Konten, Schlüssel und personenbezogenen Daten übernommen werden sollten.
Die sinnvollere Trennung lautet:
- gleich oder kompatibel: Softwareversionen, Container, Datenbankschema, Deployment-Reihenfolge und fachliche Regeln;
- bewusst verschieden: Domains, Zugangsdaten, Empfänger, externe Konten, Aufbewahrungsfristen und Skalierung;
- transformiert oder ersetzt: personenbezogene Inhalte, private Medien, Sitzungen, Tokens und ausgehende Jobs.
Die TYPO3-Dokumentation zu Umgebungsstufen beschreibt getrennte Konfigurationen für Entwicklung, Staging und Produktion. Umgebungsabhängige Werte wie Datenbankzugang, Mailtransport oder externe Dienste können über Umgebungsvariablen beziehungsweise separate Konfigurationsdateien eingebunden werden; echte Geheimnisse gehören dabei nicht ins Versionskontrollsystem. (TYPO3: Configuring environments)
Ein Staging-System sollte folglich eigene technische Identitäten besitzen:
- eigener Datenbankbenutzer,
- eigene SMTP- oder Mail-Capture-Konfiguration,
- eigene API-Schlüssel oder deaktivierte Adapter,
- eigene Storage-Zugänge,
- eigene OAuth-Clients und Callback-URLs,
- eigene Signatur- und Sitzungsschlüssel.
OWASP nennt die Wiederverwendung nichtmenschlicher Identitäten zwischen Test und Produktion als konkretes Risiko. Ein kompromittiertes Staging darf nicht über gemeinsam genutzte Schlüssel auf Produktionsressourcen zugreifen können. (OWASP: Environment Isolation)
Datenbereinigung ist eine Pipeline, kein Such-und-Ersetzen
Ein Produktions-Dump enthält nicht nur offensichtliche Felder wie Namen und E-Mail-Adressen. Personenbezogene oder vertrauliche Informationen können auch in Freitext, Logs, Dateimetadaten, Suchindizes, Jobnutzlasten, Audit-Datensätzen und Extension-spezifischen Tabellen vorkommen.
Eine belastbare Bereinigung beginnt daher mit einer tabellen- und feldbezogenen Richtlinie:
tables:
  fe_users:
    action: replace
    fields:
      email: deterministic_email
      name: synthetic_name
      password: invalidate
  be_sessions:
    action: truncate
  sys_log:
    action: truncate
  tx_app_message:
    action: synthetic_fixture
Deterministische Ersatzwerte sind hilfreich, wenn Beziehungen oder Dublettentests erhalten bleiben sollen. Dieselbe Eingabe erzeugt dabei innerhalb eines Restore-Laufs denselben Ersatzwert. Der geheime Transformationsschlüssel darf nicht in Staging liegen und sollte nicht erlauben, Werte zurückzurechnen.
Pseudonymisierte Daten bleiben allerdings nicht automatisch harmlos. Wenn zusätzliche Informationen eine Zuordnung ermöglichen, benötigen auch die transformierten Daten angemessene Schutzmaßnahmen. Für viele Tests sind vollständig synthetische Fixtures oder gezielt reduzierte Datensätze deshalb die bessere Wahl.
Die aktuelle TYPO3-Dokumentation empfiehlt, personenbezogene Daten nicht ungefiltert in Nicht-Produktionssysteme zu kopieren, sensible Tabellen auszuschließen und Inhalte zu anonymisieren oder zu pseudonymisieren. Sie nennt unter anderem Benutzer-, Sitzungs- und Protokolltabellen als Kandidaten für reduzierte Dumps. (TYPO3: Synchronizing database content)
Die Transformation selbst braucht Tests. Ein einfacher Negativscan kann beispielsweise bekannte Produktionsdomains, E-Mail-Muster, Telefonnummern oder gezielt in den Quelldatensatz eingebrachte Markierungen suchen. Ein erfolgreich ausgeführtes Bereinigungsskript beweist noch nicht, dass jede relevante Tabelle erfasst wurde.
Dateien gehören zum selben Vertrag
Datenbank und Uploads lassen sich in TYPO3 nicht unabhängig voneinander betrachten. FAL verbindet physische Dateien, Metadaten, Verwendungen und verarbeitete Varianten über mehrere Tabellen und Speicherorte.
Ein Restore kann daher verschiedene Strategien verfolgen:
- Freigegebene öffentliche Medien werden konsistent übernommen.
- Private oder personenbezogene Uploads werden entfernt oder durch Fixtures ersetzt.
- Verarbeitete Dateien werden ausgelassen und nach dem Restore neu erzeugt.
- Zugehörige Datenbankeinträge werden passend zur gewählten Strategie bereinigt.
Die TYPO3-Dokumentation weist darauf hin, dass verarbeitete Dateien und sys_file_processedfile zusammenpassen müssen. Werden die Derivate nicht kopiert, kann die Tabelle geleert werden, damit TYPO3 sie bei Bedarf neu erzeugt. Sie empfiehlt außerdem, nutzerverwaltete Dateien auf persönliche oder sensible Inhalte zu prüfen und gegebenenfalls reduzierte beziehungsweise künstliche Dateisätze einzusetzen. (TYPO3: Synchronizing user-uploaded files)
Damit wird ein häufig übersehener Fehler sichtbar: Nur die Dateinamen zu anonymisieren reicht nicht. Ein Foto, PDF oder Audiodokument kann selbst sensible Inhalte enthalten. Wo eine zuverlässige Inhaltsbereinigung nicht möglich ist, ist Ausschluss meist sicherer als Transformation.
Ausgehende Wirkung muss geschlossen beginnen
Eine frisch wiederhergestellte Umgebung darf nicht sofort arbeiten, als wäre sie Produktion. Datenbanktabellen können wartende E-Mails, Webhooks, Push-Nachrichten oder KI-Jobs enthalten. Scheduler und Worker könnten diese Aufträge direkt nach dem Start übernehmen.
Der Restore sollte deshalb zunächst in einer Quarantänephase laufen:
Netzwerkzugang begrenzt
Scheduler gestoppt
Queue-Worker gestoppt
Mail umgeleitet
Webhooks deaktiviert
externe Adapter simuliert oder blockiert
öffentliche Routen noch nicht freigegeben
Erst danach werden Daten transformiert und ausgehende Aufträge entfernt oder ausdrücklich in ungefährliche Testfälle übersetzt. Eine reine Konfigurationsänderung am Mailtransport genügt nicht, wenn weitere Kanäle wie SMS, Push, Social Publishing oder direkte Anbieter-APIs existieren.
Besonders robust ist eine Kombination aus mehreren Grenzen:
- Anwendungskonfiguration verwendet Testadapter.
- Netzwerkregeln verhindern Verbindungen zu Produktionsendpunkten.
- Staging-Credentials besitzen dort ohnehin keine Rechte.
- Ein Freigabetest prüft, dass bekannte Produktionshosts nicht erreichbar oder konfiguriert sind.
So hängt die Sicherheit nicht von einem einzelnen korrekt gesetzten Boolean ab.
„Container läuft“ ist kein Abnahmekriterium
Nach Datenimport und Transformation müssen Dienste in der richtigen Reihenfolge starten. Dabei ist „Prozess wurde gestartet“ nicht gleichbedeutend mit „Dienst ist bereit“.
Die Docker-Dokumentation unterscheidet genau diese Zustände: Compose wartet ohne zusätzliche Konfiguration nur darauf, dass ein Container läuft. Mit Healthchecks und service_healthy kann ein abhängiger Dienst dagegen warten, bis beispielsweise die Datenbank tatsächlich Anfragen annimmt. (Docker: Control startup order)
Ein technischer Healthcheck sollte dennoch klein bleiben. Er beweist nicht den vollständigen fachlichen Zustand. Für die Staging-Freigabe braucht es eine gestufte Prüfung:
Technische Bereitschaft
- Datenbank und Cache sind erreichbar.
- Schema und Migrationen sind aktuell.
- Schreibbare Verzeichnisse besitzen passende Rechte.
- benötigte Schlüssel können geladen werden.
- Worker und Scheduler sind absichtlich aktiv oder inaktiv.
Strukturelle Konsistenz
- zentrale FAL-Referenzen zeigen auf vorhandene beziehungsweise bewusst ersetzte Dateien;
- Pflichtkonfigurationen und Sites sind vorhanden;
- keine Produktionsdomain ist als kanonische Staging-URL aktiv;
- alte Sitzungen und Zugriffstokens sind ungültig;
- Queue-Zustände entsprechen der Staging-Richtlinie.
Fachliche Smoke-Tests
- Anmeldung mit einem dedizierten Testkonto;
- Aufruf einer repräsentativen Seite und API;
- kontrollierter Dateiabruf;
- Ausführung eines ungefährlichen Hintergrundjobs;
- Versand einer Nachricht ausschließlich an den Testempfänger;
- Erzeugung und anschließende Entfernung eines Testobjekts.
Diese Prüfungen sollten auf erwartete Eigenschaften zielen, nicht bloß Statuscode 200 sammeln.
Ein Restore muss reproduzierbar scheitern
Der wertvollste Restore-Test ist nicht immer der erfolgreiche. Kontrollierte Fehler zeigen, ob der Ablauf verständlich und fortsetzbar ist:
- Was geschieht bei einer fehlenden Archivdatei?
- Wird eine falsche Prüfsumme vor dem Import erkannt?
- Stoppt der Ablauf, wenn die Datenbereinigung eine unbekannte sensible Tabelle findet?
- Bleiben Worker deaktiviert, wenn ein Smoke-Test scheitert?
- Kann nach einem Abbruch sicher neu begonnen werden?
- Wird eine inkompatible Anwendungsversion eindeutig gemeldet?
Ein Restore-Lauf sollte eine eigene ID und ein persistentes Protokoll besitzen. Dieses Protokoll enthält Schritte, Artefaktversionen und bereinigte Fehlercodes, aber keine kopierten Datensätze oder Geheimnisse.
created
→ artifacts_verified
→ infrastructure_ready
→ data_restored
→ data_transformed
→ services_started
→ acceptance_passed
→ released
Jeder Übergang sollte eine klare Vorbedingung haben. released darf beispielsweise nur erreichbar sein, wenn Transformation und Abnahmetests zum selben Restore-Lauf gehören. Dadurch kann ein alter grüner Test nicht versehentlich einen neueren, fehlerhaften Import freigeben.
Staging darf vergänglich sein
Eine über Jahre weitergepflegte Staging-Datenbank sammelt eigene Sonderfälle: manuelle Korrekturen, veraltete Konten, Testdateien und Konfiguration, die nie wieder aus einem Backup entstehen würde. Je länger die Umgebung lebt, desto weniger belegt sie die Wiederholbarkeit des Prozesses.
Regelmäßiger Neuaufbau ist deshalb ein Qualitätsmerkmal. Das muss nicht für jeden Commit geschehen. Je nach Risiko kann ein sinnvoller Rhythmus sein:
- schlanker Aufbau mit synthetischen Fixtures in jeder Pipeline;
- nächtlicher oder wöchentlicher Restore eines bereinigten Backups;
- vollständige Wiederherstellungsübung vor größeren Releases;
- zusätzliche manuelle Übung nach Änderungen an Storage, Verschlüsselung oder Infrastruktur.
Nach Ablauf der festgelegten Lebensdauer wird die Umgebung wieder entfernt. Damit gehören auch Staging-Daten, temporäre Schlüssel, Logs und exportierte Artefakte in einen eigenen Lösch- und Aufbewahrungsvertrag.
Vera als konkrete Ausprägung
Nach den bereitgestellten Projektinformationen wird die getrennte Staging-Instanz von Vera aus bereinigten Produktions-Backups aufgebaut. Ausgehende E-Mails werden dort umgeleitet und Push-Nachrichten deaktiviert. Backups, Wiederherstellungsskripte, Healthchecks und Hintergrundhygiene sind als Bestandteile des Projekts beschrieben.
Das ist eine konkrete Eigenschaft dieses Projekts. Daraus folgt weder eine allgemeine Aussage über rechtliche Konformität noch der Nachweis, dass jeder denkbare Ausfallpfad bereits geprüft wurde.
Die übertragbare Architekturidee ist enger: Eine persönliche Anwendung mit TYPO3, privaten Medien, Redis, einem separaten Memory-Dienst und asynchronen KI-Workern kann Staging nicht als isolierte CMS-Kopie behandeln. Der Wiederherstellungsvertrag muss auch abgeleitete Speicher, wartende Arbeit und Kommunikationskanäle berücksichtigen.
Für andere Projekte kann der Umfang kleiner oder anders verteilt sein. Der Prüfgedanke bleibt derselbe: Jede Komponente, die für einen erfolgreichen Restore erforderlich ist oder nach dem Start Außenwirkung erzeugen kann, gehört ausdrücklich in den Ablauf.
Eine praktische Abnahmeliste
Vor der Freigabe einer wiederhergestellten Staging-Umgebung sollten sich diese Fragen beantworten lassen:
- Sind Anwendungsversion, Datenbank und Dateien über ein gemeinsames Manifest verbunden?
- Wurden Integrität und Entschlüsselbarkeit der Artefakte vor dem Import geprüft?
- Besitzt Staging vollständig getrennte Konten, Schlüssel und technische Identitäten?
- Kann die Umgebung auf Produktionsressourcen zugreifen?
- Welche Tabellen, Felder und Dateien werden entfernt, ersetzt oder pseudonymisiert?
- Prüft ein Test, ob bekannte sensible Muster nach der Transformation noch vorkommen?
- Passen FAL-Datensätze, Originaldateien und verarbeitete Dateien zusammen?
- Sind Sitzungen, Tokens und wartende Produktionsjobs ungültig gemacht?
- Bleiben Scheduler und Worker bis zur kontrollierten Freigabe gestoppt?
- Werden E-Mail, Push, Webhooks und weitere ausgehende Kanäle getrennt abgesichert?
- Prüfen Healthchecks tatsächliche Bereitschaft statt nur laufende Prozesse?
- Belegen fachliche Smoke-Tests Lesen, Schreiben, Hintergrundarbeit und Bereinigung?
- Kann ein unterbrochener Restore sicher neu gestartet werden?
- Wird die Umgebung regelmäßig vollständig neu aufgebaut?
- Existiert eine begrenzte Aufbewahrungsfrist für Staging-Daten und Restore-Protokolle?
Wiederherstellbarkeit ist eine Systemeigenschaft
Staging ist am wertvollsten, wenn es nicht nur eine Voransicht des nächsten Releases bietet. Als automatisierte Wiederherstellungsprobe verbindet es Backup, Deployment, Datenschutz und Betrieb in einem überprüfbaren Ablauf.
Dadurch werden unbequeme Abhängigkeiten früh sichtbar: der undokumentierte Schlüssel, die manuell kopierte Datei, der Worker mit Produktionszugang oder die Datenbanktabelle, die kein Bereinigungsskript kennt. Genau diese Erkenntnisse machen die Umgebung nützlich.
Der entscheidende Qualitätsmaßstab lautet daher nicht: „Sieht Staging aus wie Produktion?“ Sondern: „Kann das System aus bekannten Artefakten kontrolliert neu entstehen, ohne dabei die Grenzen zur Produktion zu verlieren?“