04 / Blog · 17.10.2026
KI braucht einen Jobstatus, keinen Ladeindikator
Generative KI passt selten in den klassischen Rhythmus aus Request und Response. Ein belastbarer Hintergrundprozess macht Laufzeit, Fehler, Wiederholungen und menschliche Entscheidungen sichtbar – und verbessert damit Architektur wie Nutzererlebnis.
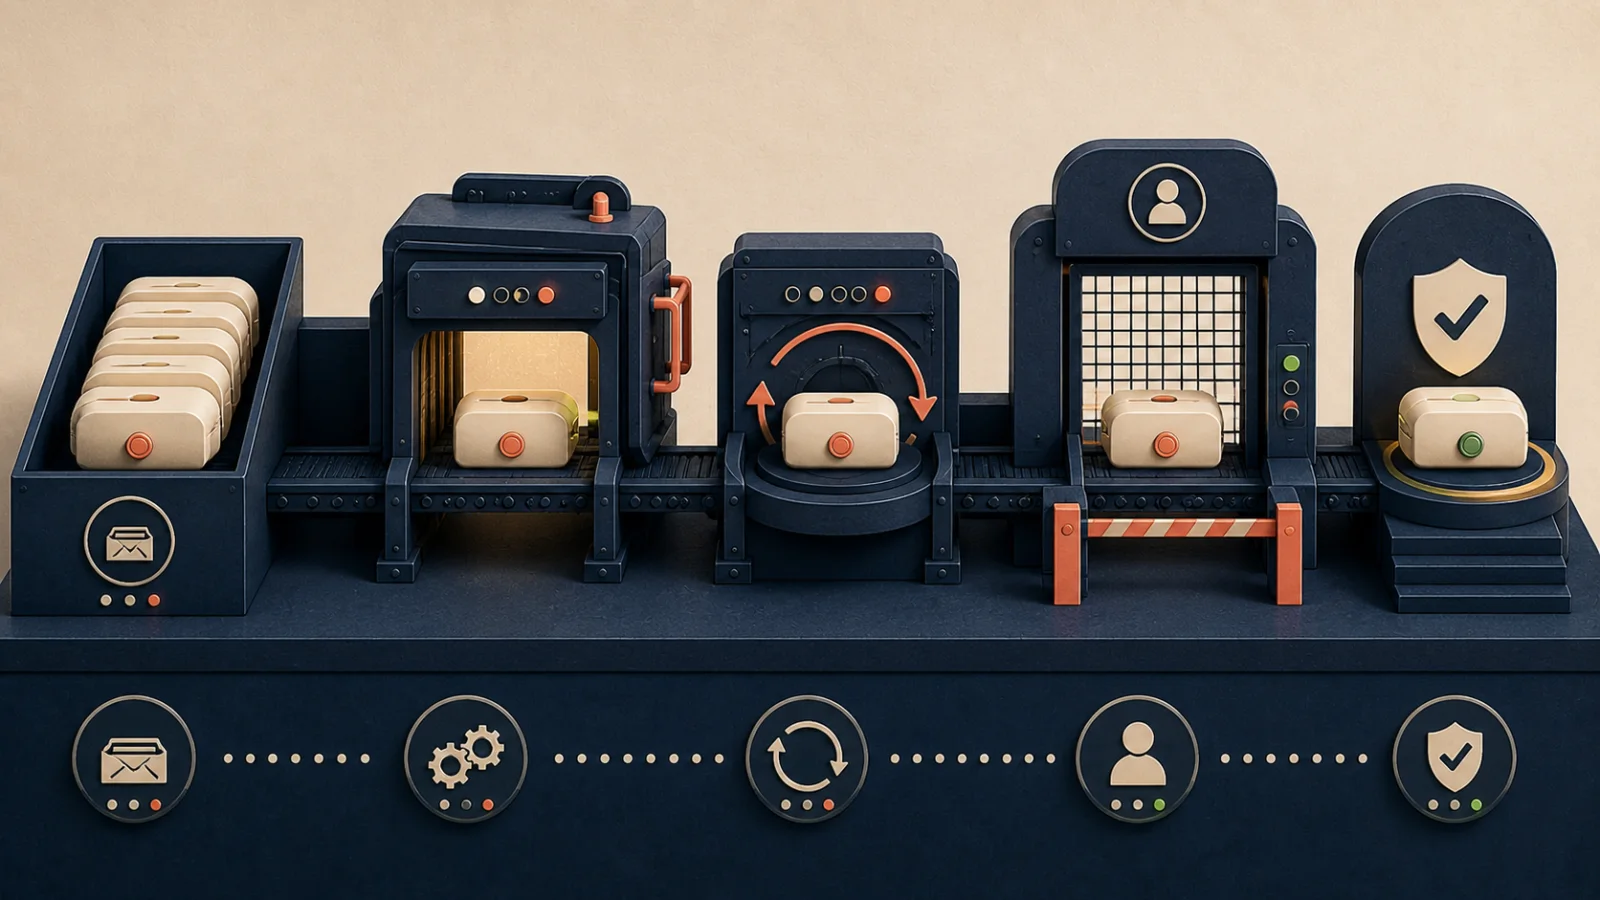
Das Zeitproblem ist ein Architekturproblem
Eine gewöhnliche Webanfrage folgt einem beruhigend einfachen Modell: Der Browser sendet Daten, der Server verarbeitet sie und liefert eine Antwort. Für viele KI-Funktionen ist dieser enge Rahmen ungeeignet. Antworten können lange dauern, externe Dienste vorübergehend ausfallen und einzelne Verarbeitungsschritte wiederholt werden müssen. Vielleicht verlangt das Ergebnis außerdem eine Validierung oder menschliche Freigabe.
Ein längerer HTTP-Timeout löst diese Probleme nicht. Er verschiebt sie lediglich. Der Browser weiß weiterhin nicht, ob noch gearbeitet wird, ein Worker ausgefallen ist oder die Verbindung nur unterbrochen wurde. Ein endlos rotierender Ladeindikator behauptet Gewissheit, obwohl das System selbst keine besitzt.
Die robustere Grundannahme lautet deshalb: Eine KI-Aufgabe ist kein verlängerter Request, sondern ein fachlicher Vorgang mit eigener Identität und eigenem Lebenszyklus.
Diese Sichtweise ist inzwischen auch in aktuellen Plattform-APIs erkennbar. Die OpenAI Responses API unterstützt Hintergrundausführung; Webhooks unterscheiden unter anderem abgeschlossene, fehlgeschlagene und abgebrochene Antworten. Zugleich weist die offizielle Dokumentation darauf hin, dass Hintergrundverarbeitung Auswirkungen auf die Datenhaltung hat und nicht mit jeder Zero-Data-Retention-Konfiguration vereinbar ist. Asynchronität ist damit nicht nur eine Performance-Option, sondern Teil des Datenschutz- und Betriebsvertrags. (OpenAI Webhook Events, OpenAI Data Controls)
Ein Job ist mehr als ein Eintrag in einer Warteschlange
Eine Queue beantwortet zunächst nur die Frage, welche Arbeit als Nächstes ausgeführt werden soll. Für eine verlässliche Produktfunktion braucht es darüber hinaus ein persistentes Jobmodell. Ein sinnvoller Datensatz enthält mindestens:
- eine zufällige, von außen nicht erratbare Job-ID,
- Typ und Eigentümer der Aufgabe,
- den aktuellen Zustand,
- Erstellungs-, Start- und Abschlusszeitpunkt,
- Anzahl und Zeitpunkt der Versuche,
- eine begrenzte, bereinigte Fehlerbeschreibung,
- Verweise auf Eingabe und Ergebnis,
- eine Korrelations-ID für Logs und externe Aufrufe.
Die Eingaben sollten nicht gedankenlos in den Job kopiert werden. Bei persönlichen oder sicherheitsrelevanten Daten ist ein Verweis auf die fachliche Quelle oft besser. Der Worker lädt dann nur das, was er für den konkreten Schritt benötigt und wozu der Auftraggeber weiterhin berechtigt ist.
Auch das Ergebnis gehört nicht zwingend direkt in dieselbe Tabelle. Große Texte, Bilder und Audiodateien benötigen eigene Speicher-, Berechtigungs- und Löschregeln. Der Job hält dann lediglich den nachvollziehbaren Zusammenhang zwischen Auftrag und Artefakt fest.
Zustände statt boolescher Abkürzungen
is_done = 0 reicht nicht. Zwischen „noch nicht fertig“ und „fertig“ liegen mehrere fachlich unterschiedliche Situationen. Ein überschaubares Zustandsmodell könnte so aussehen:
queued → running → succeeded
              ↘ retry_wait → queued
              ↘ failed
queued/running → cancel_requested → cancelled
Bei komplexeren Abläufen kommen Zustände wie waiting_for_input, waiting_for_review oder blocked hinzu. Entscheidend ist nicht die Zahl der Zustände, sondern ihre eindeutige Bedeutung. Für jeden Übergang muss feststehen:
- Wer darf ihn auslösen?
- Welche Daten werden dabei geschrieben?
- Was sieht der Nutzer?
- Welche Folgearbeit wird angestoßen?
- Darf der Übergang wiederholt eintreffen?
Diese letzte Frage ist besonders wichtig. Worker können nach einem Timeout neu starten, Webhooks mehrfach eintreffen und Netzverbindungen genau nach erfolgreicher Verarbeitung abbrechen. Ein Callback ist deshalb nicht automatisch ein neues Ereignis. Übergänge sollten atomar prüfen, ob Job-ID, erwarteter Ausgangszustand und aktuelle Ausführungs-ID zusammenpassen.
Das schützt auch vor einem subtilen Fehler: Ein verspätetes Ergebnis aus einem alten Lauf darf keinen neu gestarteten Job überschreiben.
Mindestens einmal bedeutet: möglicherweise zweimal
Viele Warteschlangensysteme garantieren praktisch eine Zustellung „mindestens einmal“. Das ist vernünftig, zwingt aber zur Idempotenz. Derselbe Auftrag kann erneut ausgeführt werden, ohne dass dadurch zwei Benachrichtigungen, doppelte Abbuchungen oder widersprüchliche Datensätze entstehen dürfen.
Dafür haben sich einige einfache Muster bewährt:
- Jeder fachliche Auftrag erhält einen stabilen Idempotenzschlüssel.
- Ein Worker beansprucht einen Job durch ein atomares Update oder eine Sperre.
- Externe Seiteneffekte werden getrennt von der reinen Berechnung behandelt.
- Ergebnis und Folgeschritt werden über eine transaktionale Outbox verbunden.
- Wiederholte Callbacks bestätigen den bekannten Zustand, statt ihn erneut auszulösen.
Auch TYPO3 bringt für wiederkehrende Hintergrundarbeit bereits nützliche Grundlagen mit. Der Scheduler kann einmalige und periodische Aufgaben ausführen, parallele Ausführungen blockieren und Start, Ende sowie Fehler protokollieren. Die Dokumentation empfiehlt für neue eigene Aufgaben bevorzugt Symfony Commands. Ein Scheduler ersetzt zwar keine fachliche Queue, eignet sich aber gut als kontrollierter Taktgeber für Worker, Bereinigung und Wiederanläufe. (TYPO3 Scheduler 13.4, Scheduler-Überblick, Eigene Scheduler-Aufgaben)
Wiederholen ist eine fachliche Entscheidung
Nicht jeder Fehler verdient einen weiteren Versuch. Eine brauchbare Klassifikation unterscheidet mindestens:
- temporäre Fehler: Rate Limit, Netzwerkunterbrechung oder kurzzeitig nicht verfügbarer Dienst;
- dauerhafte technische Fehler: ungültige Konfiguration oder nicht unterstütztes Datenformat;
- fachliche Fehler: fehlende Freigabe, gelöschte Quelldaten oder unzureichende Eingaben;
- Qualitätsfehler: formal gültiges, aber nicht akzeptables Ergebnis.
Nur die erste Gruppe lässt sich normalerweise automatisch mit exponentiellem Backoff und Zufallsanteil wiederholen. Die Zahl der Versuche braucht eine feste Obergrenze. Andernfalls erzeugt ein defekter Auftrag eine Endlosschleife, verbraucht Budget und verdeckt seine Ursache.
Fachliche und qualitative Probleme benötigen dagegen einen sichtbaren Zustand und häufig eine menschliche Entscheidung. „Bitte ergänze die Akzeptanzkriterien“ ist keine technische Störung. Das System sollte daraus keinen fünften identischen Modellaufruf machen.
Genau hier unterscheidet sich ein Lieferprozess von einem Chat: Das Modell darf feststellen, dass ihm Informationen fehlen. Ein guter Workflow behandelt diese Feststellung als korrektes Zwischenergebnis.
Die Oberfläche muss ehrlich bleiben
Asynchrone Architektur ist erst vollständig, wenn die Benutzeroberfläche ihre Zustände verständlich abbildet. Nach dem Absenden sollte sie sofort die angenommene Aufgabe mit stabiler ID anzeigen. Danach kann sie den Status per Polling, Server-Sent Events oder WebSocket aktualisieren.
Die Transportwahl ist zweitrangig. Wichtiger sind klare Aussagen:
- „Die Aufgabe wartet auf Verarbeitung.“
- „Die Verarbeitung läuft.“
- „Ein vorübergehender Fehler ist aufgetreten; der nächste Versuch erfolgt später.“
- „Für die Fortsetzung fehlen Informationen.“
- „Die Aufgabe ist endgültig fehlgeschlagen.“
Ein Fortschrittsbalken ist nur sinnvoll, wenn der Prozess tatsächlich messbare Abschnitte besitzt. Eine frei erfundene Prozentzahl macht das System nicht transparenter. Benannte Phasen wie „Audio transkribieren“, „Entwurf erzeugen“ und „Ergebnis prüfen“ sind meist ehrlicher.
Abbrechen benötigt ebenfalls einen definierten Vertrag. Ein laufender externer Aufruf lässt sich unter Umständen nicht sofort stoppen. cancel_requested beschreibt dann zunächst die Absicht. Der Worker muss vor weiteren Seiteneffekten erneut prüfen, ob der Auftrag noch fortgesetzt werden darf.
Zwei Projekte, zwei Ausprägungen desselben Prinzips
In den bereitgestellten Projektinformationen zu Vera werden KI-Aufgaben außerhalb normaler HTTP-Requests verarbeitet. TYPO3 legt Jobs ab, kontrollierte Worker führen sie aus und liefern strukturierte Resultate zurück. Für eine persönliche Tagebuchanwendung ist das mehr als eine Skalierungsentscheidung: Langsame Antworten erhalten einen ehrlichen Status, Wiederholungen bleiben begrenzt und Löschvorgänge müssen auch Langzeitgedächtnis, Medien und abgeleitete Verweise konsistent erfassen.
AI Development wendet dasselbe Grundprinzip auf einen deutlich längeren Prozess an. Dort durchläuft eine Jira-Aufgabe Bereitschaftsprüfung, isolierte Bearbeitung, Tests, unabhängige Auswertung und menschliche Abnahme. Fehlende Informationen, Qualitätsfehler, Merge-Konflikte und Infrastrukturprobleme besitzen getrennte Wege. Undurchsichtige Run-IDs verhindern laut Projektbeschreibung, dass verspätete Callbacks einen neueren Lauf überschreiben.
Das sind konkrete Eigenschaften dieser beiden Projekte. Die daraus folgende allgemeine Empfehlung lautet nicht, jede Anwendung müsse genau diese Architektur kopieren. Sie lautet: Sobald eine Funktion langsam, teuer, wiederholbar oder freigabepflichtig ist, sollte ihr Lebenszyklus explizit modelliert werden.
Sicherheit folgt dem Auftrag, nicht dem Worker
Ein Hintergrundprozess darf nicht automatisch alle Rechte des Gesamtsystems erben. Der Job sollte festlegen, auf welche Ressourcen der konkrete Lauf zugreifen darf. Kurzlebige Zugangsdaten, minimale Tool-Rechte und getrennte Steuerungs- und Ausführungsumgebungen reduzieren die Folgen eines manipulierten Inputs oder fehlerhaften Modellergebnisses.
Ebenso wichtig ist die erneute Autorisierung beim Ausführen. Zwischen dem Einstellen und dem Start eines Jobs kann ein Nutzer seine Rechte verlieren oder Quelldaten löschen. Eine Berechtigung, die gestern bestand, ist keine dauerhafte Vollmacht.
Für irreversible oder weitreichende Schritte bleibt eine explizite Freigabe sinnvoll. Aktuelle OWASP-Leitlinien für agentische Anwendungen betonen ebenfalls Least Privilege, klar authentifizierte Werkzeugzugriffe und menschliche Prüfung bei erheblichen Abweichungen. (OWASP Securing Agentic Applications Guide)
Was im Betrieb sichtbar sein muss
Ein produktiver KI-Workflow braucht keine möglichst große Zahl von Metriken, sondern beantwortbare Betriebsfragen:
- Wie viele Jobs warten, laufen, scheitern oder benötigen eine Entscheidung?
- Wie alt ist der älteste wartende Job?
- Welche Fehlertypen treten gehäuft auf?
- Wie lange dauern einzelne Phasen?
- Wie viele Wiederholungen und externe Aufrufe entstehen?
- Welche Modell-, Prompt- und Tool-Version erzeugte ein Ergebnis?
- Kann ein Operator einen festhängenden Lauf sicher beenden oder neu starten?
Prompts und Modellantworten pauschal zu protokollieren ist dabei keine gute Standardlösung. Logs sollten Zustände und technische Diagnoseinformationen liefern, ohne persönliche Inhalte oder Zugangsdaten zu vervielfältigen. Für fachliche Nachvollziehbarkeit können Hashes, Versionen, strukturierte Ergebnisfelder und gezielt geschützte Audit-Datensätze ausreichen.
Der eigentliche Gewinn
Eine Jobarchitektur macht KI nicht zuverlässiger, als das zugrunde liegende Modell tatsächlich ist. Sie sorgt aber dafür, dass Unsicherheit nicht den gesamten Prozess beherrscht. Fehler werden klassifizierbar, Wiederholungen begrenzbar, Rechte überprüfbar und menschliche Entscheidungen zu sichtbaren Bestandteilen des Systems.
Der wichtigste Wechsel findet deshalb im Datenmodell statt: nicht „Wir warten noch auf eine Antwort“, sondern „Dieser Vorgang befindet sich in einem bekannten Zustand“. Sobald diese Unterscheidung getroffen ist, werden Oberfläche, Tests, Betrieb und Datenschutz wesentlich konkreter.
Ein guter KI-Workflow verspricht keine Magie in Echtzeit. Er zeigt, was gerade geschieht, welche Grenzen gelten und wer als Nächstes entscheiden muss.